执行摘要#
建议:数据指向暂不全量上线——第 7 天回访 −0.82pp 统计显著但效应量极小(Cohen’s h = −0.021),收益侧零改善;这不是"保守没结论",是把"统计显著"与"值得上线"分开之后的正常决策。
三条核心结论:
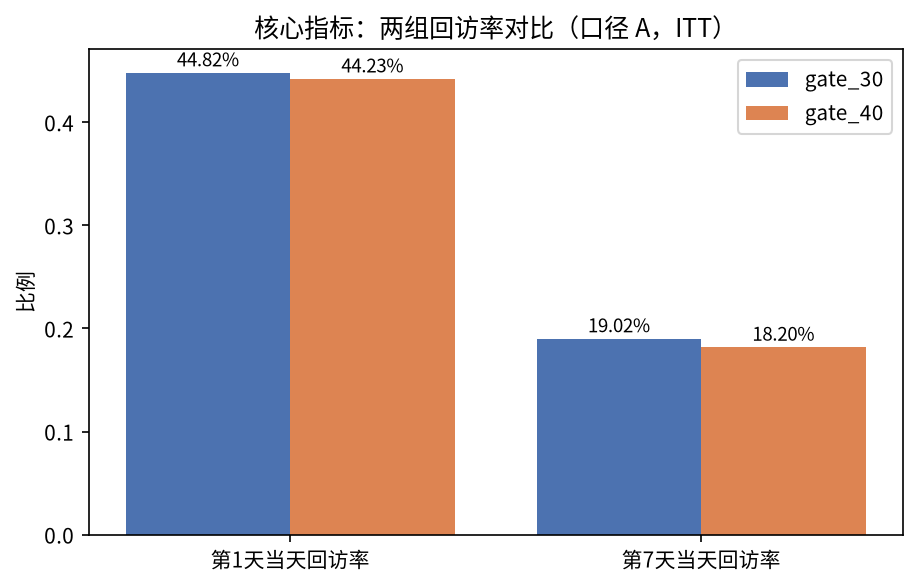
- 成本侧成立但很小:第 7 天回访 19.02% vs 18.20%(−0.82pp、相对 −4.3%),Bootstrap 5,000 次重抽样 99.9% 为负——方向稳健、不是噪声;但效应量极小,约每 122 名 gate_40 玩家少 1 人回来。
- 收益侧零改善:游玩深度持平(≥30 回合 37.26% vs 36.52%、≥40 回合 30.35% vs 30.40%),第 1 天回访不显著(−0.59pp、p = 0.074)——改动没有带来任何收益。
- 成本由高活跃玩家承担:负向信号集中在鲸鱼(−2.36pp)与重度玩家(−1.38pp)——若上线,对游戏价值最高的人群先付成本。
执行策略:双轨决策——当前证据下不全量上线;若门后移的业务目标是变现且收入增量能覆盖约 −0.8pp 周回访成本,可上线或带变现指标重跑实验。边界:数据集不含任何变现 / 收入字段,轨道 2 的判断无法在本数据内完成。
背景与问题定义#
Cookie Cats 是移动拼图游戏,关卡之间设"门"(gate):到达门口须等待或付费才能继续。门放太早劝退新手,放太晚损失变现机会——门的位置是变现与留存的权衡。业务方做了一次 A/B 测试:把第一个门从第 30 关移到第 40 关,90,189 名新玩家随机分入两组(gate_30 44,700 / gate_40 45,489)。
要回答的不是"差异显不显著"的统计练习,而是一个有真实 revenue 含义的上线决策:该不该全量上线?
分析框架:上线决策 = 收益侧 + 成本侧 + 置信度#
把上线决策拆成三个子问题,每个子问题对应一组指标与一套检验:
- 改动是否伤害游玩深度(Guardrail)——回合数分布对比;若伤害成立,决策直接终止。
- 留存是否下降(核心成本)——第 1 天与第 7 天回访分别检验:两者是独立事件(3,599 名玩家第 7 天回访但第 1 天没有,占 7 天回访者 21.4%),不是"连续留存到第 N 天"。
- 负向信号集中在谁身上(子群)——按活跃度分层;前置声明局限:子群只生成假设,不用于决策。
校验链按顺序执行,任何一环失败结论即作废:SRM → 功效 → Guardrail → 核心检验 → 子群。顺序即纪律:先确认实验可信,再谈结论;先谈效应大小,再谈显著与否。
核心发现#
发现 1|第 7 天回访 −0.82pp:真实,但很小#
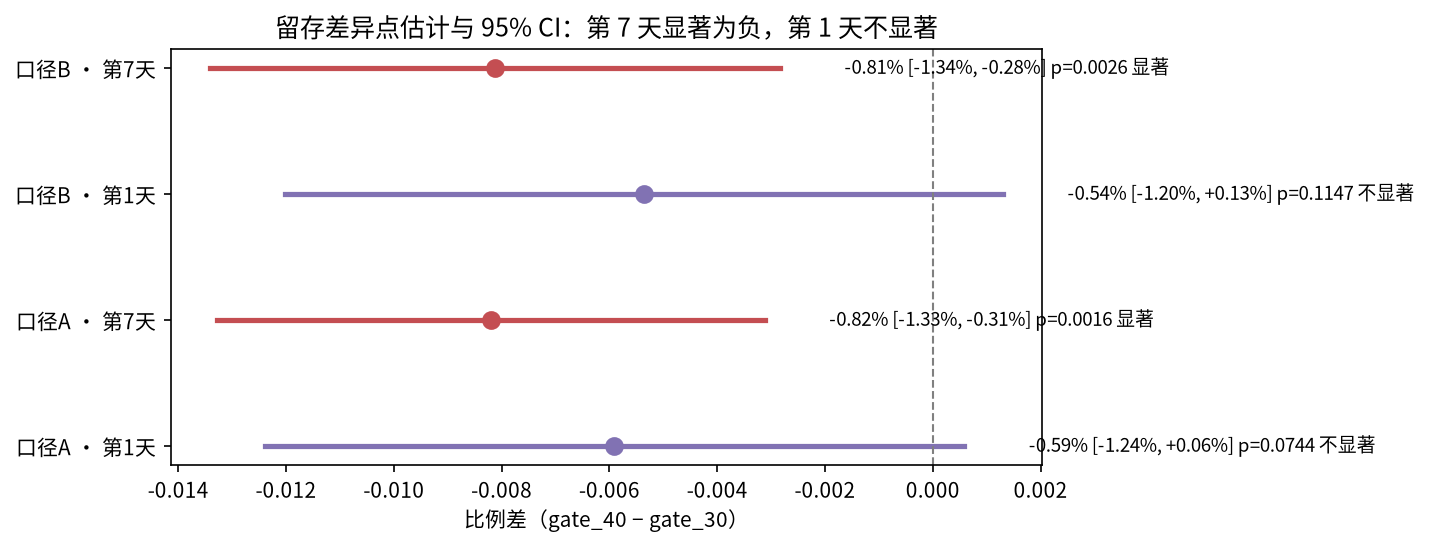
数据事实:第 7 天当天回访 19.02% vs 18.20%(−0.82pp、相对 −4.3%),p = 0.0016,Newcombe 95% CI [−1.33%, −0.31%] 不含 0;Bootstrap 5,000 次重抽样 95% CI [−1.33%, −0.32%] 与之几乎重合,99.9% 重抽样为负。
为什么重要:归因分三层。是不是噪声——不是,两路 CI 重合、99.9% 为负;是不是够大——不是,Cohen’s h = −0.021,其 Bootstrap CI 整条远低于 0.2 的小效应阈值;统计真实,业务很小,统计显著 ≠ 业务显著。
策略建议:成本侧成立,但幅度本身不足以单独支撑上线决策——必须与收益侧(发现 2、3)合并权衡后进入双轨决策。
发现 2|第 1 天回访不显著,但与第 7 天同向#
数据事实:第 1 天当天回访 44.82% vs 44.23%(−0.59pp),p = 0.074,95% CI [−1.24%, +0.06%] 含 0。
为什么重要:“一个显著一个不显著"不是矛盾:两差异方向一致(都为负),差别在证据强度。把第 1 天读成"无影响"是误读证据结构;把两天合并成"连续留存"则误读了事件定义。
策略建议:上线决策以第 7 天为主口径,第 1 天作方向性参考;汇报中两天并列呈现、分别检验。
发现 3|Guardrail 未触发:改动没有伤害游玩深度#
数据事实:回合数极端右偏(中位数 17 vs 16,最大 49,854);Mann-Whitney U p = 0.0502 恰在边界,但 Cliff’s delta = 0.0075 远低于 0.147 的"可忽略"阈值;均值差 Bootstrap 95% CI [−4.07, +0.96] 回合含 0;“玩到门附近"的比例两组几乎一样(≥30 回合 37.26% vs 36.52%,≥40 回合 30.35% vs 30.40%)。
为什么重要:深度未受损,意味着上线决策只需权衡留存成本,不必叠加体验债风险;同时也示范了一条纪律——边界 p 值不定论,效应量定论。
策略建议:Guardrail 不构成上线阻碍;若重跑实验,沿用同一 Guardrail 作固定项。
发现 4|负向信号集中在高活跃玩家(探索性,不用于决策)#
数据事实:鲸鱼(55+ 回合)−2.36pp(p = 0.0005)、重度(19–54 回合)−1.38pp(p = 0.0055),均过 Bonferroni 参考线(α/7 ≈ 0.0071);轻量 / 中量 / 零回合不显著。
为什么重要:它指出成本由谁承担——对游戏价值最高的人群先付损失。若未来上线,这是监控清单的第一项。
局限与建议:sum_gamerounds 是 post-treatment 变量,子群成员资格被处理污染(≥30 回合比例两组差 −0.74pp 显著),叠加多重比较——本节只生成假设:如上线,优先监控高活跃玩家留存。
综合策略与收益预估#
策略是双轨决策,而不是二选一:
- 轨道 1(当前证据下):不全量上线 gate_40——收益侧零改善,成本侧有一个稳健但很小的第 7 天回访下降,且集中于高活跃玩家,决策不对称不成立。
- 轨道 2(条件路径):若门后移的业务目标是变现(如测试付费墙时点),且收入增量能覆盖约 −0.8pp 周回访的成本,可考虑上线,或带变现指标重跑实验。效应量极小意味着这个成本并非不可承受——关键是决定权交给收入端。
- 边界声明:数据集不含任何变现 / 收入字段,轨道 2 的判断无法在本数据内完成——这是分析标注的边界,不是被回避的问题。
收益预估与边界:没有上线,就没有实测回收——本项目的回收以另一种形式呈现:它把一次错误全量的决策成本(全体玩家承担、高活跃玩家集中流失的风险)归零,并把"要不要上线"转化为收入端可计算的条件问题(收入增量是否覆盖 −0.8pp 周回访成本)。若轨道 2 条件成立,重跑实验的设计——Guardrail 前置、双口径、效应量阈值先注册——可直接复用本项目的校验链。
可信度验证#
- SRM 检查随机分组:gate_40 占 50.44%,p = 0.0086 统计显著,但 Cohen’s w = 0.0087 远低于 0.1 小效应阈值——大样本下"显著但无实际意义”,带警示继续。
- 功效计算:80% 功效下 MDE 约第 1 天回访 0.9pp、第 7 天 0.7pp;第 7 天观测差 0.82pp 高于其 MDE,“检出显著"与功效预期自洽。
- Guardrail 检验:见发现 3——以效应量定论,不以边界 p 值定论。
- 核心检验互校验:双比例 Z 与卡方互为校验(z² = χ²),Newcombe 置信区间,Cohen’s h 效应量。
- 口径稳健:主口径 ITT,剔除零回合玩家(4.43%)作敏感性口径,两口径方向一致。
经验迁移与拓展收益#
这个项目沉淀的是一条决策纪律:统计显著与业务显著是两个问题,必须分开回答、按顺序回答。显著性回答"是不是真的”,效应量回答"值不值得”,子群回答"谁在承担"——三者缺一,上线决策就是掷硬币。这条纪律同样适用于质检场景的规则调整:调整前后的差异显著,不等于调整值得全量推广。
代码与数据#
- GitHub:ArlesZhang/Mobile_Games_AB_Testing-Cookie_Cats
- 仓库含:4 个 notebook(业务理解+实验校验 / EDA+Guardrail / 核心留存检验 / Bootstrap+子群)、9 张分析图表、
docs/interview_prep.md面试叙事版 - 数据:Kaggle 公开数据集(Cookie Cats,90,189 名玩家);分析代码与结论供学习与作品集用途