执行摘要#
建议:Olist 的增长瓶颈不在"顾客不买",而在"买一次就流失"——复购率仅 3.00% 是最值得投入的杠杆;履约端运输 9.3 天是唯一有优化空间的环节。
三条核心结论:
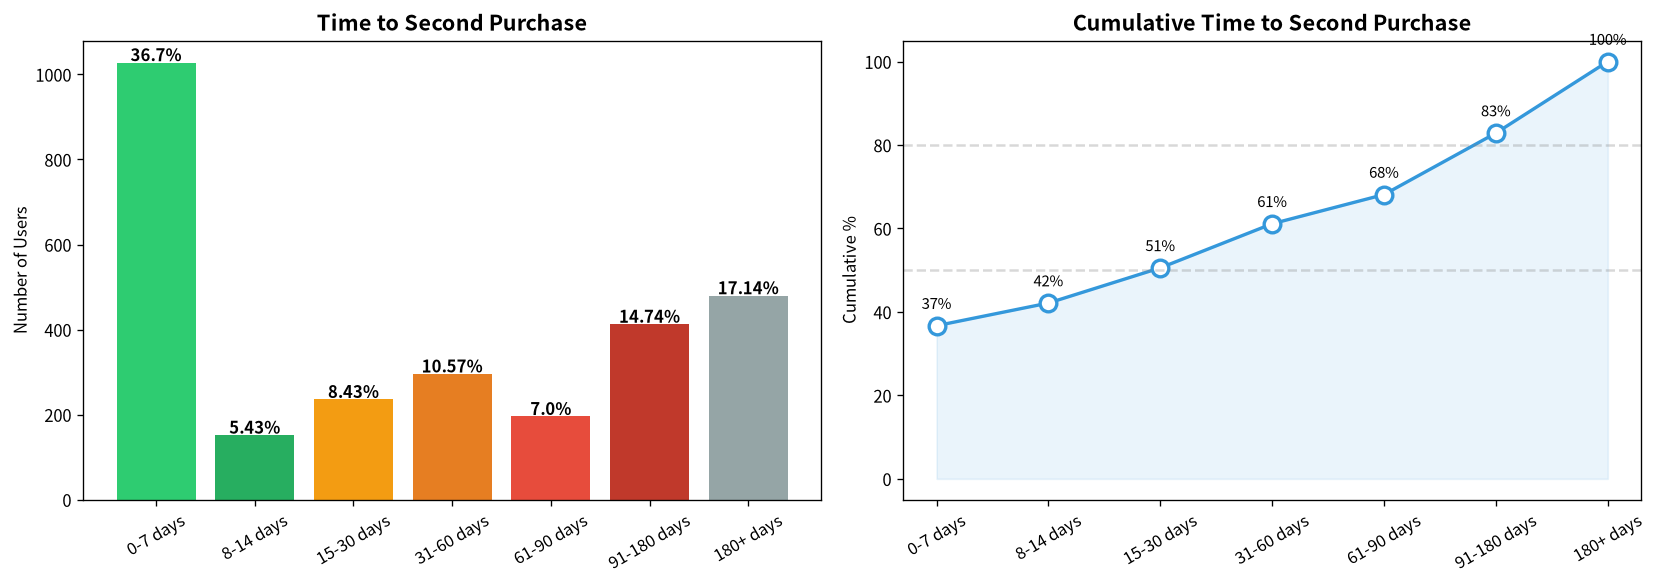
- 留存是最大增长杠杆:93,358 位用户中仅 2,801 位购买 2 次及以上,复购率 3.00%;复购窗口集中在首单后 30–90 天,错过窗口即永久流失。
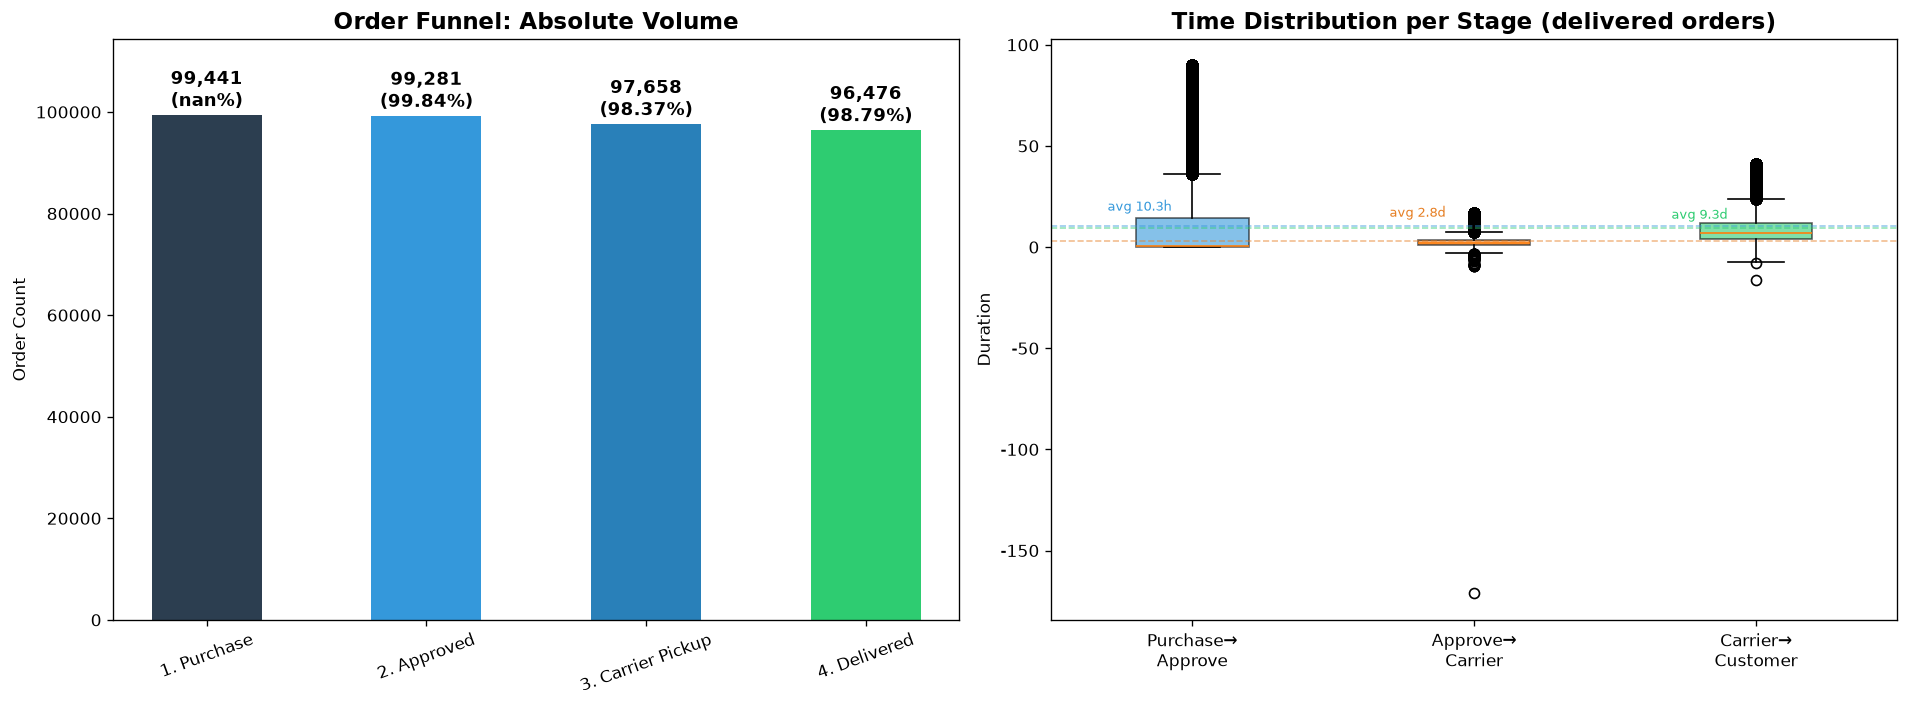
- 运输是履约端唯一可优化环节:下单到送达全程 12.6 天中运输占 9.3 天;P95 送达 20.5 天直接制造 11.51% 的 1 星差评,负体验再反压复购。
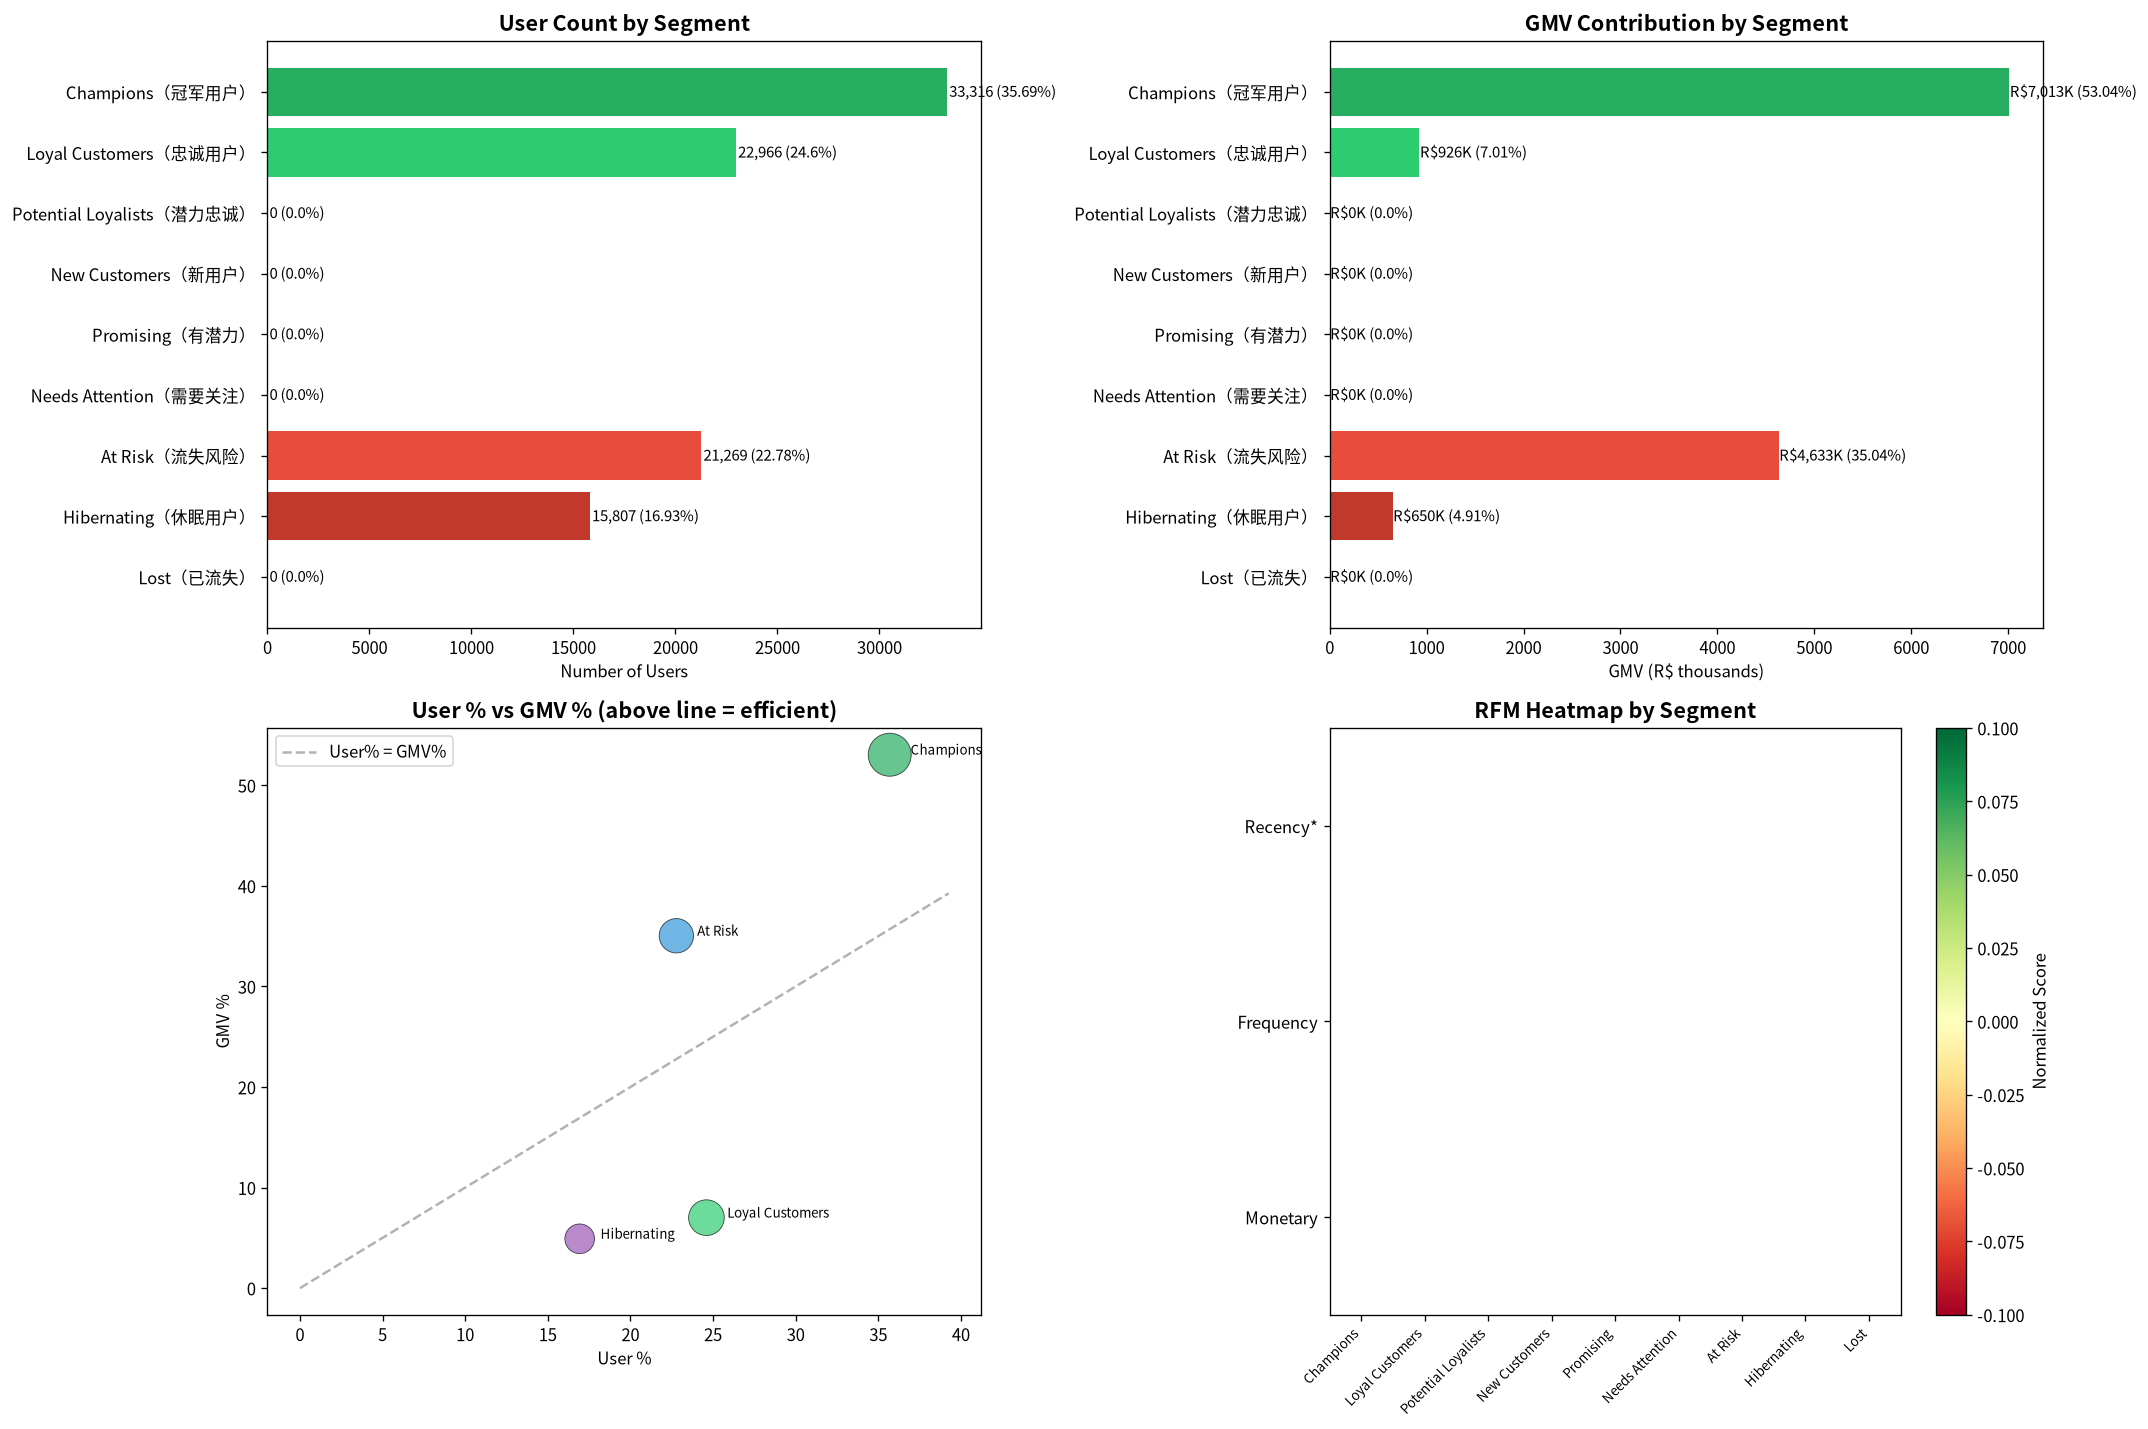
- 用户资产高度集中:RFM 八分群中 Champions 的 GMV 占比显著高于人数占比,At Risk(曾高频、现不活跃)仍贡献大量 GMV——召回成本低于获客成本,召回优先级最高。
策略与收益:新客首单后 30 天内建立 7/15/25 三次触达节奏,运输时效谈 SLA 并对 P95 超长等待主动补偿,按 RFM 分层召回;按 README 估算口径,四项策略合计约 R$700K+(均为估算、非实测,明细见「综合策略与收益预估」)。
背景与问题定义#
Olist 是巴西最大的电商平台之一,连接巴西各地的卖家与买家。数据集覆盖 2016.9–2018.10:约 10 万笔订单、96,096 位用户。分析要回答四个业务问题:
- 平台当前运营状况如何?(订单规模、用户行为、履约效率)
- 用户流失的瓶颈在哪里?(转化问题?履约问题?还是复购问题?)
- 如何提升 GMV?(优先投入哪些策略、预期收益多少?)
- 不同用户群体如何差异化运营?(谁值得重点维护、谁需要召回?)
数据与口径#
- 范围:数据集全部订单、用户、履约、评价与支付字段。
- 用户级口径:用户级指标统一用
customer_unique_id——用订单口径复购率会失真,发现 1 的可靠性系于这个口径。 - 实现:四阶段分析以 DuckDB SQL 与 Pandas 双实现,另用纯 SQL(窗口函数 / 多层 CTE / 多表 JOIN / PIVOT / 分位数)从零复刻一遍,逐项对账一致(详见「可信度验证」)。
分析框架:从总到分#
把 GMV 拆成"获客 → 履约 → 复购"三个环节,每个环节用一个视图回答,顺序即理由:
- 履约漏斗——损耗在哪?先定位断点再谈优化,而不是平均用力。
- RFM 分层——谁值得投?区分维护对象与召回对象,资源不撒胡椒面。
- Cohort 留存——何时动手?让复购窗口决定触达节奏,而不是让日历决定。
三个视图合起来,把"提升 GMV"从口号变成带优先级的动作清单:漏斗回答损耗在哪,RFM 回答谁值得投,Cohort 回答何时动手。
核心发现#
发现 1|复购率仅 3.00%,是平台最大的增长杠杆#
数据事实:93,358 位用户中只有 2,801 位购买 2 次及以上;人均购买频次 1.03 次、中位数 1 次,最高一位用户购买 15 次。平台在持续买入新客,而几乎全部新客在首单后流走。
为什么重要:复购是 GMV 结构中唯一不靠追加获客预算就能增长的环节。量化:复购率 3% → 5% = 额外 1,867 位复购用户 × 人均 R$141.62 ≈ R$264K 增量 GMV——三个杠杆里成本最低、效果最直接的一个。
策略建议:把留存列为平台第一策略,在首单后窗口内建立全程触达机制(节奏见发现 4)。
发现 2|运输 9.3 天是履约最大瓶颈,也是唯一有优化空间的环节#
数据事实:下单到送达全程平均 12.6 天——审批 10.3 小时(几乎即时)→ 揽收 2.8 天 → 运输 9.3 天;P95 送达时间 20.5 天,11.51% 的订单只得 1 星差评。
为什么重要:长等待直接制造差评,差评再压制复购——履约问题与留存问题在同一时点叠加。排除的候选:审批与揽收几乎无流失且已接近极限,压缩它们收益有限,优化它们等于优化不是问题的问题。
策略建议:与物流商谈 SLA 或引入多家竞争;对 P95 超长等待订单主动触达、补偿,压低差评率。预期收益(估算口径):平均送达 9.3 天降至 7 天,差评率预计降 3–5%、留存率提升 2–3%。
发现 3|Champions 与 At Risk 贡献了不成比例的 GMV#
数据事实:R/F/M 五分位打分(因数据偏态实际分箱少于 5)+ 中位数阈值分群,把用户分成 8 个群体;Champions(高频高消费)的 GMV 占比显著高于人数占比;At Risk(曾高频、现在不活跃)仍在贡献大量 GMV。
为什么重要:召回一个 At Risk 用户的成本低于获取一个新客——同样预算投在召回上的期望收益高于投在拉新上;反之,对所有用户无差别投入,会把大部分资源浪费在 Lost 组。
策略建议:分层运营——At Risk 最高优先级召回(大额优惠券 + 专属客服);Champions 走 VIP 服务与新品优先体验;New Customers 首单后 7 天内触达、引导第二单;Lost 低成本触达、不投大额优惠券。
发现 4|复购窗口集中在首单后 30–90 天,触达节奏由此决定#
数据事实:首月留存(M0→M1)在所有 Cohort 中都极低;大部分复购发生在首单后 30–90 天内;品类复购率差异显著:health_beauty、bed_bath_table(快消 / 日用品)高于 watches_gifts(高客单价)。
为什么重要:窗口有时效——首单后 30 天内不触达,等于永久错过复购窗口;品类结构则为个性化推荐指明方向(“买了床品的人还买了什么”)。
策略建议:7/15/25 三次触达节奏——第 7 天感谢信 + 品类推荐 → 第 15 天限时优惠券 → 第 25 天紧迫感提醒;品类交叉推荐(买 bed_bath_table 的用户推 health_beauty)。预期收益(估算口径):首月留存 2% → 4% 约 +R$200K。
综合策略与收益预估#
| 策略 | 预期收益 | 实现难度 | 证据 |
|---|---|---|---|
| 复购率提升(3% → 5%,7/15/25 触达) | R$264K | 中 | Cohort 窗口 + 品类关联 |
| 运输时效优化(SLA + P95 补偿) | R$150K+ | 高 | 漏斗断点 + P95 / 差评数据 |
| At Risk 用户召回(+10%) | R$100K+ | 低 | RFM 分群 + 召回 / 获客成本结构 |
| 首月留存提升(2% → 4%) | R$200K+ | 中 | Cohort 留存 |
| 总计 | R$700K+ | — | 以上均为 README 估算口径,非实测 |
实施顺序:先触达节奏(成本最低、窗口假设验证最快)→ At Risk 召回(难度低)→ 留存提升 → SLA 谈判(难度高、周期长,待前三项产出数据后启动)。不做什么同样写清:Lost 组不投大额优惠券(召回期望收益低于券成本);不做定价归因(数据无价格字段,不越界下结论);不压缩审批与揽收(已接近极限,不是问题)。
可信度验证#
- 口径验证:用户级指标统一
customer_unique_id,避免订单口径虚增复购率。 - 双实现互证:DuckDB SQL 与 Pandas 双实现,另用纯 SQL 从零复刻、逐项对账一致;结论整合为 12 张图的离线可交互 Plotly 看板(KPI 卡片 + 业务解读)。
- 边界声明:收益数字全部为 README 估算口径、非实测;数据无价格与投放字段,不产出定价与渠道归因结论。
经验迁移与拓展收益#
这个项目沉淀的是一条排序判断:先定位断点再谈优化,先排杠杆再投资源。它在任何链路型业务都成立——质检场景里,对应先定位损耗集中的环节,再决定检查与培训资源的投放顺序。而这份汇报的最小单元——“数据事实 → 为什么重要 → 策略建议”——也是分析连接决策的最小单元;后续 P2、P3 沿用同一单元,升级的只是问题的难度。
代码与数据#
- GitHub:ArlesZhang/Ecommerce-Funnel-Behavior-Analysis
- 仓库含:4 个分析 notebook(业务理解 / 漏斗 / RFM / 留存)、13 张分析图表、纯 SQL 复刻(4 个 .sql + workbook,口径与 notebook 逐项对账)、Plotly 交互看板
- 数据:Olist 巴西电商公开数据集(Kaggle,约 10 万订单 / 96,096 用户,CC BY-SA 4.0)