执行摘要#
建议:统一改手机渠道对新客有正效应——经可观测因素调整后的效应估计为 +8.1pp [7.1, 9.2];但这个数字只适用于能匹配的新客(匹配率 29.9%),对匹配不到的客群与座机停用的月份,如实声明估计不了。结论的两半缺一不可。
三条核心结论:
- 生命周期状态几乎决定转化,渠道是二阶变量:老客·曾成功 65.11% vs 新客 8.83%,差距 56.3pp(新客占 86.3%)——不先分层,任何"渠道效应"都会被客群构成污染。
- 渠道效应真实但有边界:方案 A +8.13pp [+7.1, +9.2]、方案 B +7.84pp [+6.8, +8.9] 双规格互证方向一致;作用域限定在新客层的共同支撑域内,不外推到全体新客。
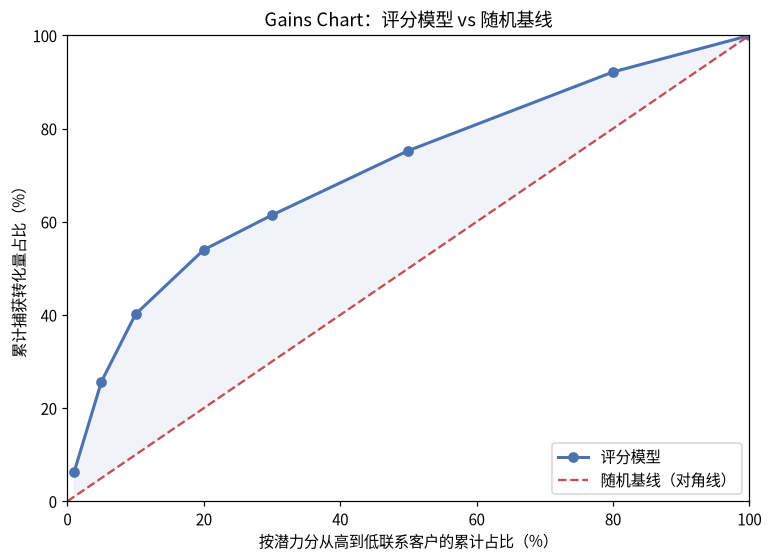
- 名单是比渠道更大的杠杆:按潜力分排序,Top 20% 名单捕获 54.0% 的转化量(OOF AUC 0.7403)——在外呼资源固定的前提下,排序收益直接可兑现,不依赖渠道切换。
策略与收益:新客优先手机渠道、外呼顺序按潜力分排、Top 20% 名单打满;回归客层不动渠道。本项目无上线条件,以上均为效应估计与判别力、非实测收益,边界逐条见「收益预估与边界」。
背景与问题定义#
UCI Bank Marketing 数据集,41,188 条葡萄牙银行电话营销记录(正类 11.27%)。销售打给谁、用什么渠道、打几次,都是现场判断,不是随机分配——没有 A/B 测试可用,只有历史观察数据。
要回答的决策问题:把外呼渠道统一改为手机,是真实效应,还是客群假象?
朴素答案很有诱惑力:手机组 14.74% vs 座机组 5.23%,差距 +9.51pp。但这个数字混合了两件事——渠道差异与客群差异(座机组接到哪些客户本身不随机)。分析的起点是不相信它。
数据与口径:可做性检查先于一切#
动手建模前,先对每个字段做"能不能用"的判定——这一步决定后面所有数字的可信度:
duration(通话时长)是数据泄漏:它是结果不是原因,任何"外呼前决策"模型禁用。campaign(拨打次数)是反向因果变量:打得多本身就是"销售判断有希望"的结果,只做描述性呈现、不做因果声称。- 宏观共线组不进模型:VIF 63.9 / 32.9 / 30.7,时间代理只用
month。 pdays=999是哨兵值:4,110 条曾联系记录同为 999,旅程判定一律用previous>0,不把哨兵当数值。- 类别不平衡(正类 11.27%):全程不用 Accuracy 作评价指标。
分析框架:分层 → 关联 → 调整,三层递进#
把"渠道效应是真是假"拆成三层递进的问题,顺序即纪律——分层先于匹配:
- 生命周期分层——先把人群分开:客户现在处于什么状态?
- 层内渠道关联——差异存在于哪一层:在哪层渠道与转化有关联,就只在哪层做调整。
- PSM 调整——剥离可观测混杂:把"外呼前已知信息"中可观测的客群构成差异剥离掉,比较"相似的客户"。
每一层都为下一层缩小作用域;质量门(匹配质量不达标就不出数字)贯穿全程。
核心发现#
发现 1|生命周期状态几乎决定转化,渠道是二阶变量#
数据事实:老客·曾成功 65.11% vs 新客 8.83%,差距 56.3pp(新客占样本 86.3%);再触达窗口内回归客 63.83% vs 窗口外 12.94%。
为什么重要:客群状态与渠道在原始数据里是纠缠的——座机组里老客占比更高,朴素的 +9.51pp 有相当部分其实是"老客转化本来就高"。不先分层,渠道效应的任何估计都不可信。同时它给出业务杠杆的排序:客户状态管理(窗口期内触达)比渠道选择更大。
策略建议:生命周期分层固化为名单管理的第一刀;回归客在再触达窗口内优先联系,不等窗口过期。
发现 2|渠道差异只存在于新客层,PSM 的作用域由此确定#
数据事实:新客层 contact 与转化关联 V = 0.1219(手机 11.7% vs 座机 4.7%);回归客层 V = 0.0108、p = 0.42,不显著。
为什么重要:调整只该发生在有关联的层。回归客层渠道与转化无关联——在这一层硬做调整,是制造问题而不是解决问题。
策略建议:PSM 的作用域限定为新客层;回归客层不投入渠道调整资源(其质量门判定见发现 4)。
发现 3|调整后效应 +8.1pp:数字变了形状,但没有消失——三条边界必须一起说#
数据事实:四个口径的完整对比——
| 口径 | 手机组 | 座机组 | 差距 (pp) | 95% CI | 性质 |
|---|---|---|---|---|---|
| 朴素 · 全量 | 14.74% | 5.23% | +9.51 | — | 含选择偏差(客群+旅程混杂) |
| 朴素 · 限定新客 | 11.73% | 4.69% | +7.04 | — | 含选择偏差(客群混杂) |
| PSM · 方案 A(主规格) | 13.77% | 5.64% | +8.13 | [+7.1, +9.2] | 经可观测因素调整后的效应估计 |
| PSM · 方案 B(替换规格) | 13.80% | 5.96% | +7.84 | [+6.8, +8.9] | 同上 |
为什么重要:三个必须一起说清的点——
- 适用边界量化:匹配成功率 29.9%——方案 A 完成 6,259 对匹配(caliper = 0.2 × logit SD),仅覆盖 20,922 名手机组新客中的 29.9%。ATT 只在"能找到可比座机组"的客群上估计,不外推到全体新客;匹配样本的月份构成必须连带报告:may 58.1%、jul 10.1%、aug 8.9%、jun 8.4%——ATT 实际上是在"座机仍被使用"的月份上估计的。
- 调整后反而高于朴素新客比较(8.13pp > 7.04pp)——匹配把"座机几乎没在用的月份(aug/jul/apr)“里的手机组客户剔出样本(被剥离 14,663 人,占手机组 70.1%),而这批客户转化率本就偏低(10.9%,低于全体新客手机组的 11.7%)。这不是 PSM 出错,而是"ATT 只代表能找到可比座机组的那部分客群"这条局限的具体体现。
- 这是经可观测因素调整后的效应估计,不是因果效应——未观测混杂(销售为何选座机/手机、客户号码可得性)仍可能使估计偏离真值。
策略建议:新客优先手机渠道,但执行口径按"共同支撑域内客群"理解;座机停用月份(aug/jul/apr)不下渠道结论、不排渠道改造计划。
发现 4|回归客层:质量门不过,不出数字#
数据事实:回归客层座机组仅 403 人(vs 手机组 5,222),PSM 匹配率 7.7%、匹配后 7/58 个特征 SMD>0.1——按预定质量门判定不通过。只报告朴素差异 +2.0pp(26.79% vs 24.81%,p = 0.42 不显著)+ 局限声明。
为什么重要:“质量门不过就不出数字"的纪律比任何一个数字都值钱——给不可比的估计,比声明估计不了更糟。这一层是纪律的展示位,不是分析的失败位。
策略建议:回归客层渠道策略不动(维持现状,不投入改渠道);该层的杠杆在历史状态(pdays_bucket / poutcome),不在渠道。
发现 5|Gains 排序:名单是比渠道更大的杠杆#
数据事实:用"外呼前已知信息"训练的分层模型 OOF AUC 0.7403;按潜力分从高到低联系:Top 5% 捕获 25.7% 转化量(Lift 5.14×)、Top 10% 捕获 40.2%、Top 20% 捕获 54.0%(Lift 2.70×),曲线在头部 20% 后放缓。最强信号是"无可考历史"本身(pdays_bucket_999,系数 −1.490)。
为什么重要:效应估计回答"改渠道每人高多少”,评分模型回答"先打谁”——在外呼资源固定的前提下,排序收益直接可兑现,不需要等任何渠道切换发生。Top 20% 之后曲线放缓,说明它是 ROI 最优区间,打满即止。
策略建议:外呼顺序按潜力分排,Top 20% 名单打满,后 50% 降频或转自助渠道;对没有历史痕迹的新客,潜力评分是分层的第一刀。
综合策略与收益预估#
七条建议按证据强度分层——证据性质决定建议的置信度,也决定执行优先级:
| # | 建议 | 证据性质 | 置信度 |
|---|---|---|---|
| 1 | 新客(first_time)优先手机渠道,名单默认按手机排班 | PSM 经可观测因素调整:+8.1pp [7.1, 9.2](共同支撑域客群内) | 高 |
| 2 | 渠道差异最大的月份不是淡季;aug/jul/apr 座机停用月,渠道优先级让位于名单质量 | 数据事实 + PSM 共同支撑 | 高 |
| 3 | 外呼顺序按潜力分排,Top 20% 名单打满(捕获 54.0% 转化量),后 50% 降频或转自助渠道 | 判别力(OOF AUC 0.7403),非因果 | 中 |
| 4 | 生命周期分层 × Top20% 潜力评分双维度排优先级 | 描述性 + 判别力 | 中 |
| 5 | 回归客渠道策略不动(维持现状,不投入改渠道) | 质量门不过:证据不足,不是证无效果 | 中 |
| 6 | 前 3 次触达是黄金窗口(首次触达捕获总转化量 49.6%,前 3 次累计 88.1%),作排班 / 跟进设计参考 | 纯描述性;条件事实,不是"少打几通就少损失" | 低 |
| 7 | 不因高次数段转化率持稳给加码(6 次后的回升是选择效应外观) | 描述性 + 反向因果声明 | 低 |
实施顺序:先名单排序(收益直接可兑现、不依赖渠道切换)→ 新客手机渠道(共同支撑域内)→ 回归客窗口期触达 → 不在座机停用月份动渠道。不做什么同样写清:不用 duration 训练任何决策模型(数据泄漏);不给 campaign 下因果结论(反向因果);回归客层不出渠道数字(质量门不过)。
收益边界:本项目无上线条件,以上均为效应估计与判别力、非实测收益。可兑现的形态有两类——名单侧:Top 20% 捕获 54.0% 转化量,资源固定时优先排序直接提升转化总量;渠道侧:+8.1pp 仅适用于共同支撑域内新客,ATT 不外推,座机停用月份效应无法估计,逐条声明而不是硬跑一个数字。
可信度验证#
- PSM 四件套:混杂选择(人口统计 7 项 + month 时间代理,OneHot 后 41 维,PS AUC 0.8825)→ 共同支撑域检查 → SMD 平衡性检验 → ATT 估计。匹配后 49 个特征水平中 46 个 SMD<0.1,仅剩的 3 个全是月份(座机停用月)——属信息缺失而非匹配失败。
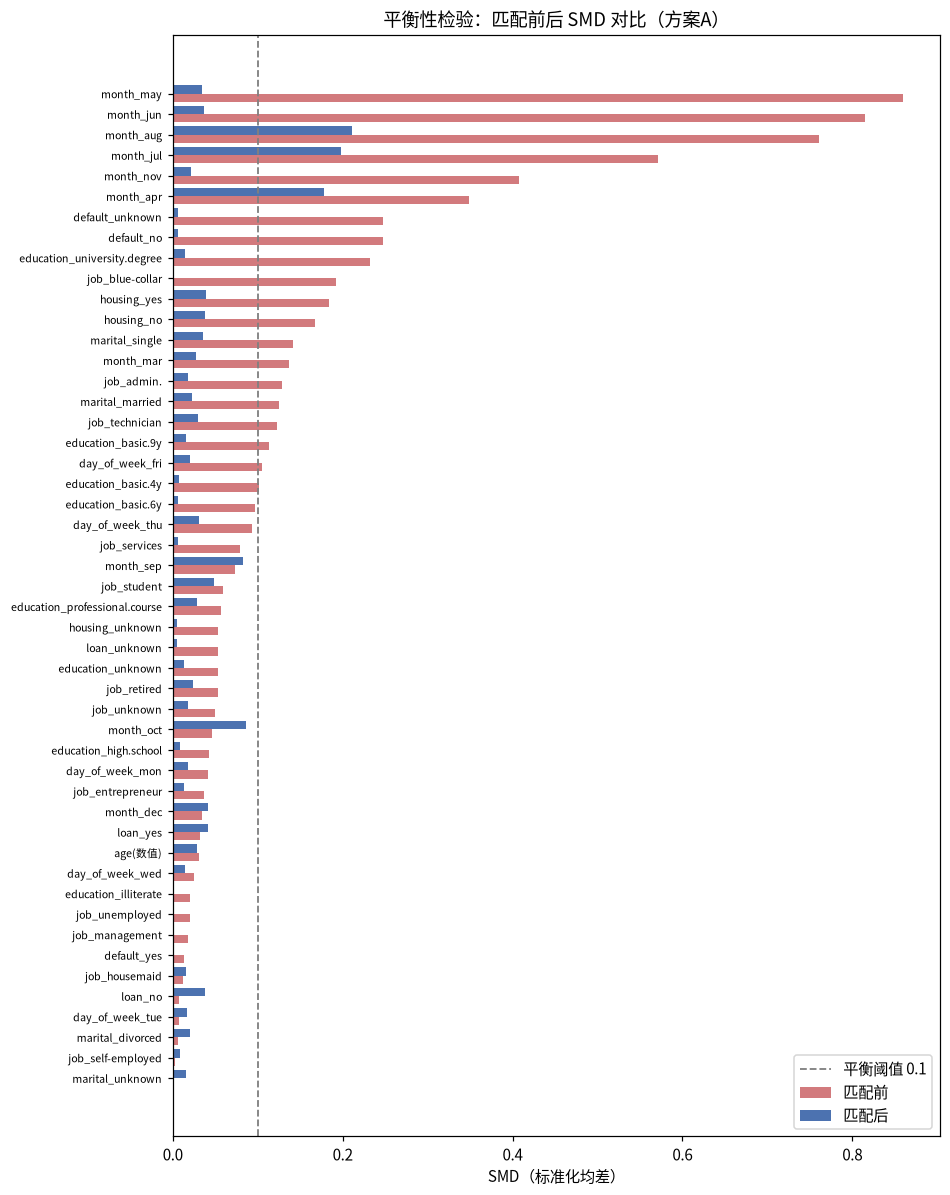
- 双规格互证:方案 A 标准 caliper-NN,方案 B 精确匹配 month + 层内 NN——结论一致才进决策口径,结论打架继续查。
- 质量门纪律:匹配质量不达标就不出数字,回归客层是这条纪律的执行记录。
- 可做性检查前置:
duration禁用、campaign只做描述、共线组不进模型——见「数据与口径」。
经验迁移与拓展收益#
货拉拉质检工作的真实困境与此同构:规则 / 话术调整上线后"看起来"变好了——这是调整本身的功劳,还是客群、时段的自然变化?这类调整几乎不走 AB 测试,只有历史观察数据。本项目跑通的不是"在公开数据集上演示 PSM",而是六个可复用的具体经验:
- 可做性检查先于一切——
campaign式反向因果变量先怀疑,再使用; - 分层先于匹配——不在纠缠的人群上直接调整;
- 共同支撑域检查是现实检验——改动后的策略在某个时段几乎全覆盖、缺对照组时,如实报告该时段效应无法估计;
- 匹配做了不算完——回报结构分布必须连带报告,“调整后估计"必须说明它代表哪部分客群;
- 双规格互证才敢下判断;
- 质量门不过就不出数字。
代码与数据#
- GitHub:ArlesZhang/Outbound-Sales-Strategy-Analysis
- 仓库含:notebooks 01–05(数据质量与生命周期分层 / 驱动因素 / 客户评分 / PSM 渠道验证 / 外呼节奏)、
docs/00_methodology_notes.md(口径与声明基准)、12 张分析图表 - 数据:UCI Bank Marketing 公开数据集(41,188 × 21,正类 11.27%)